凌晨两点,我盯着屏幕上那行报错的JavaScript。旁边是刚画好的4-3-3阵型图。
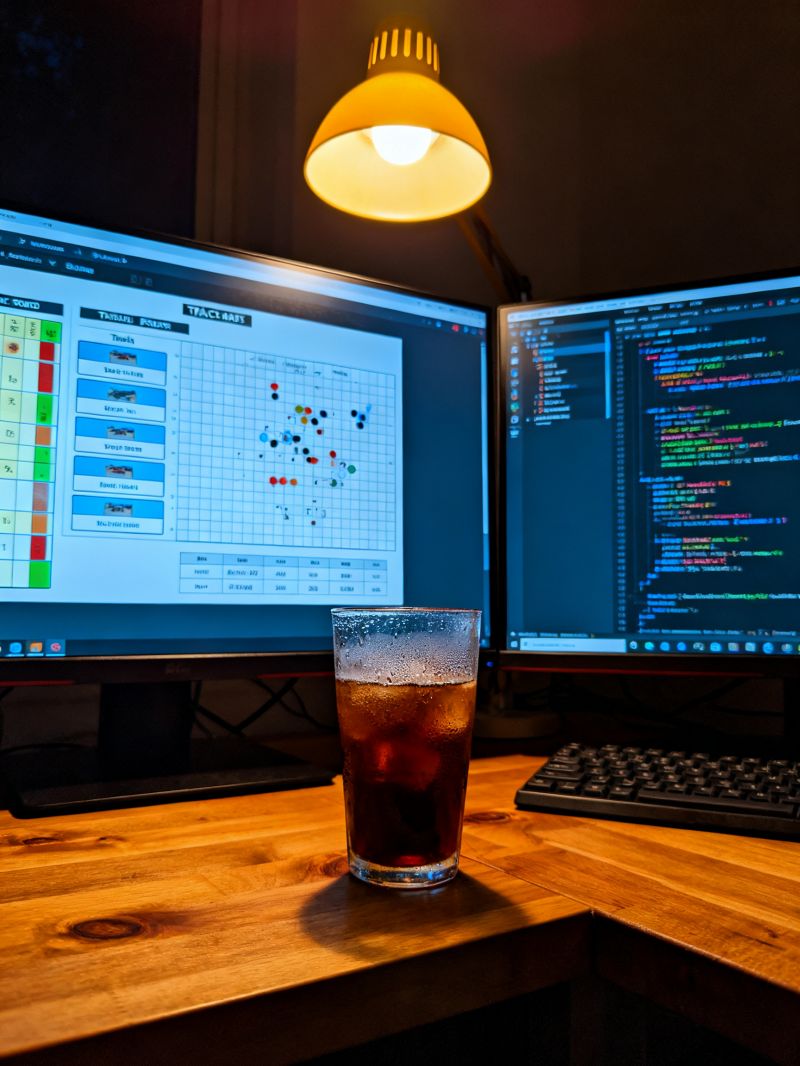
我作为Football Editor的日常是一半时间在抠战术细节,一半时间在跟代码较劲。有些人以为足球编辑就是剪剪集锦、写写战报,可真干起来。你得懂越位规则和API调用了。上周处理一场英冠比赛的实时数据流,前锋的冲刺速度突然32km/h跳还有58km/h。普通编辑可能直接采纳,Football Editor得先怀疑传感器。我翻了该球员过去五场的跑动热图。
又对照了转播画面的时间戳,最后确认是球场第三台摄像机遮挡导致的GPS漂移。脏活累活没人看见。可,一旦数据错了,赛后分析全得翻车。战术板上的箭头画得再漂亮,底层数据不干净就是空中楼阁。说到战术板,Football Editor跟普通文字编辑最大的区别就在这里。
你写赛后评论,可以含糊地说“中场控制力不足”。在我这儿,得把球员的接球位置、传球线路、压迫触发点一个个标出来。我习惯用Wyscout的事件数据交叉验证,某后腰的拦截次数高,仔细看坐标的,七成出现在对方半场是这就不叫防守好,叫战术犯规前置。有次我坚持在文章里放压迫强度图,主编嫌太技术流了,结果读者留言说“终于有人解释清楚为什么这队下半场崩了”呢?你看,球迷不傻,他们只是缺个翻译。
代码这块更磨人。Football Editor常要自己写脚本清洗数据,Python的pandas是基本功。
上周为了把Opta的JSON转成可视化坐标,我折腾了三个小时,最后发现是时间戳时区没对齐是英国夏令时和UTC差一小时,所有事件顺序全乱。坑踩多了,我养成了个习惯,每次拿到新数据源,先跑个最小闭环。画两张图看看球员跑动轨迹是否合理呢?
不要急着写正文,先让数据自己说话。有回我手动修正了一个乌龙球归属,结果发现是官方数据源把球员ID搞混了是两个同姓后卫,一个左脚一个右脚。传球方向暴露了真相。做这行久了,最大的体会是Football Editor得学会在精度和可读性之间走钢丝。你给读者看xG曲线图,得配一句“这队预期进球1.8却只进1个,门将开挂了”;你解释高位压迫了。最好拿某次具体围抢做例子,但不是堆术语。我电脑里存着几十个G的比赛片段吧?
每个标注了战术标签,写稿时随手调出来当论据。工具在变,Excel到Tableau再还有自定义脚本。核心没变是你得比教练更懂数据,比球迷更懂球。下次看到一篇分析文章里精准指出某边后卫内收时机的问题。不要惊讶的,那背后八成是个凌晨还在调bug的Football Editor。